
-

算力用在刀刃上:H200服务器最值得关注的7大高算力场景?
不是所有AI业务都需要H200,但在某些场景下,没有它,项目可能根本跑不起来。先看一个真实的选择题。某AI创业公司同时接到两个项目:一个是基于开源小模型(7B参数)为客户搭建客服机器人,日均请求量约5000次;另一个是为制造企业训练一个融合图像质检和设备数据的多模态异常检测模型,要求毫秒级响应。第一个项目,用上一代中端GPU就能轻松应对。第二个项目,团队评估后得出结论:如果不使用H200级别的高性
2026-7-23 查看更多 >> -

算力即战力:为什么AI时代的企业算力升级刻不容缓?
当竞争对手的AI模型三天完成一次迭代,你的团队却要等三周——这不是算法差距,这是算力差距。一位制造业企业的IT负责人曾跟我分享过一个让他夜不能寐的对比:他所在的企业和另一家同行几乎同时启动了AI质检项目。一年后,对方的生产线上已经部署了7个AI应用场景,从缺陷检测到设备预测维护全面铺开;而他们这边,第一个场景还在不断“优化中”。“技术方案我看过,差别不大。真正拉开差距的,是我们的GPU服务器要排队
2026-7-23 查看更多 >> -

大规模AI应用,为什么算力会从“够用”变成“不够用”?
很多企业的AI项目在测试阶段顺风顺水,一到规模化部署就全线告急——不是算法出了问题,而是算力没有跟上规模的脚步。先看一个真实的故事。某互联网公司2023年初上线了一个AI内容生成工具,最初只对内部三个团队开放,每天处理约500次请求,用的是公司数据中心里几台“闲置的GPU服务器”,运行流畅,效果不错。半年后,这个工具被推广到全公司8个部门,并开放给部分外部合作伙伴。日均请求量从500增长到2万,增
2026-7-23 查看更多 >> -
纵横算力工厂上线,一站式赋能企业 AI 应用创新
AI 技术正在重塑企业生产方式,大模型应用逐渐成为推动数字化发展的核心力量。然而,高昂的算力投入、复杂的模型部署流程以及技术门槛,成为企业迈向智能化的重要挑战。为解决企业 AI 应用落地难题,纵横数据推出「纵横算力工厂」,打造集大模型服务、API 调用、智能算力资源管理于一体的一站式智算服务平台。依托成熟的云计算基础设施和丰富的算力运营经验,纵横算力工厂帮助企业实现更加便捷、高效、安全的大模型
2026-7-10 查看更多 >> -
B300服务器如何赋能企业训练行业专属模型?
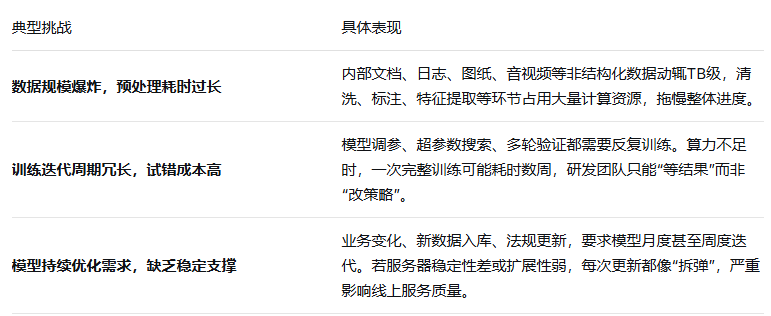
从“通用AI”到“行业专家”,企业专属模型正成为数字化竞争的关键分水岭。而算力,是跨越这道分水岭的硬核桥梁。一、为什么企业都在押注“行业专属模型”?过去两年,大模型技术飞速迭代,但越来越多的企业发现:通用大模型虽然“博学”,却未必“懂行”。制造企业需要AI精准判断设备故障根因,而不是生成泛泛的设备维护常识;金融机构要求模型吃透内部风控规则和监管条款,而非仅提供公开市场分析;医疗机构希望AI能结合本
2026-7-23 查看更多 >> -
多模态大模型爆发,B300服务器如何撑起企业AI“超级大脑”?
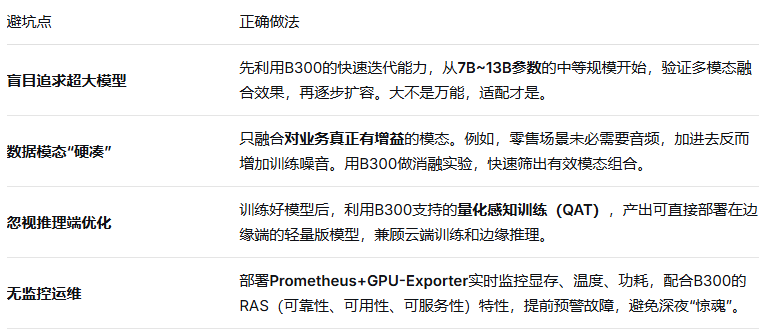
当AI不再“偏科”——能读图、会听音、看得懂视频,企业对算力的需求正迎来一场“核聚变”。B300服务器,正是那把点燃多模态应用的关键火种。一、多模态:AI的“完整认知”时代已来过去两年,我们习惯了让AI写诗、编程、做摘要。但现实世界的信息,从来不是单一文本构成的——一台机器的故障,往往藏在振动波形、热成像图和维修工单的交叉线索里;一次精准的医疗建议,需要同时理解CT影像、化验单数据和主诉文本。多模
2026-7-23 查看更多 >> -
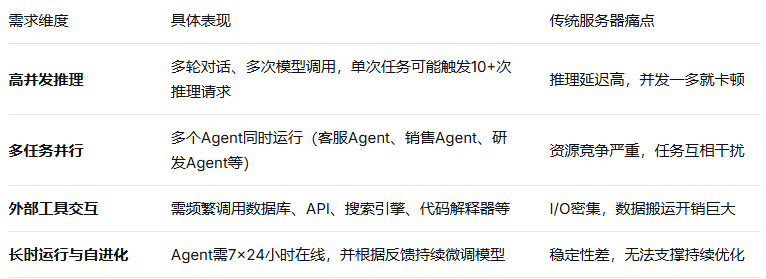
B300服务器为何成为企业级“行动派”AI的算力基石?
如果说大模型是AI的“大脑”,那么AI Agent就是让这颗大脑拥有“手和脚”的进化。当AI从“聊天”走向“办事”,算力需求正在发生质变。一、AI Agent:不只是“说”,更要“做”过去两年,我们习惯了与ChatGPT式的聊天机器人对话——你问一句,它答一句。但企业真正渴望的,是一个能主动思考、调动工具、执行任务并闭环反馈的智能体,这就是AI Agent(人工智能智能体)。举个例子:你告诉A
2026-7-23 查看更多 >> -
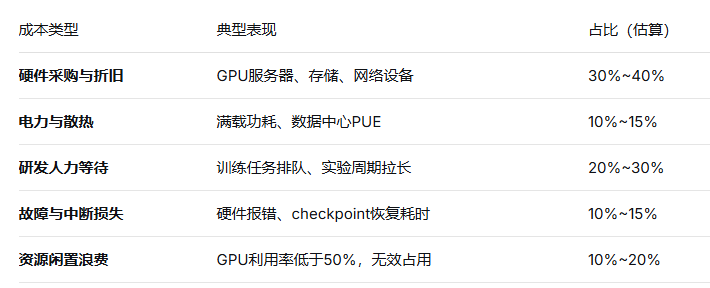
大模型训练成本居高不下?B300服务器从这5个维度帮你“精打细算”?
训练一个大模型,电费、硬件折旧、人力投入加起来动辄数百万。但真正的成本杀手不是“贵”,而是“浪费”——算力空转、数据I/O等待、故障重来……B300服务器,正是为“消灭浪费”而生。一、算力成本焦虑:企业训练大模型的真实账本很多企业决策者以为,大模型训练的成本大头在硬件采购。但实际运行后才发现,隐形成本远高于硬件本身:从表中不难看出,超过一半的成本与“效率低下”有关——算力没跑满、数据喂不饱、训练反
2026-7-23 查看更多 >> -
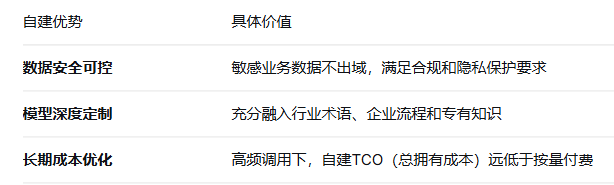
企业自建AI大模型平台,为什么B300服务器是更明智的“底盘”选择?
调用API和自建平台,好比“租房”与“购房”的区别。前者拎包入住但处处受限,后者前期投入大,但胜在自主可控、长期回报可观。而AI大模型平台的“地基”,就是算力基础设施。B300服务器,正是当下企业自建算力基座的务实之选。一、自建AI平台:从“调用”到“拥有”,算力成为第一道坎过去两年,不少企业通过调用通用大模型API快速验证了AI能力。但随着业务深入,越来越多管理者意识到:核心数据和业务流程必须掌
2026-7-23 查看更多 >> -
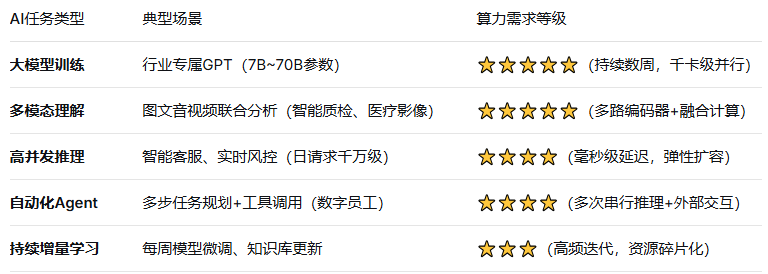
B300服务器如何扛住复杂AI任务的“算力风暴”?
从简单分类到千亿参数大模型,AI任务的复杂度正呈指数级上升。当您的模型训练需要等待数周、推理服务在高峰期频频卡顿——这不是算法的错,而是算力底座到了必须升级的时刻。一、现实之变:复杂AI任务已成企业常态,算力首当其冲三年前,企业对AI的使用还停留在“调用API做文本分类”或“训练小模型预测销量”的阶段。彼时,单卡GPU甚至CPU集群尚能应对。但今时不同往日。企业AI应用正全面进入“深水区”:这些任
2026-7-23 查看更多 >> -
B300服务器如何为企业AI计算“破壁”?
当算法团队万事俱备,模型却因算力瓶颈迟迟无法上线——这不仅是技术团队的挫败,更是企业战略的延误。B300服务器的价值,就是凿穿那些看不见的“算力之墙”。一、算力瓶颈:企业AI落地的“隐形天花板”很多企业在AI项目推进中会遇到一个诡异现象:算法论文读透了,数据也准备好了,但模型就是跑不起来,或者跑得太慢,根本没法投入实际业务。究其原因,算力已经成为制约企业AI发展的核心短板。常见瓶颈表现(看看您的企
2026-7-23 查看更多 >> -
从深度学习到大模型训练,B300服务器的算力需求演进与破解之道?
如果说深度学习是AI的“工业革命”,那么大模型就是“电力时代”——算力不再是一种选择,而是驱动一切的基础设施。B300服务器,正是这场变革中不可或缺的“发电厂”。一、算力跃迁:从“可选项”变成“必选项”过去十年,人工智能经历了两次标志性的算力跨越:阶段典型模型参数量级算力需求(估算)硬件要求传统机器学习(2010年前)SVM、随机森林千~万级数GFLOPS单CPU服务器足够深度学习(2012~20
2026-7-23 查看更多 >> -
大规模AI训练,为什么B300服务器是算力破局的“关键拼图”?
训练一个千亿参数的大模型,其算力消耗相当于让一台普通服务器连续运转数百年。当模型规模每年增长10倍,而硬件性能提升仅2倍——这个剪刀差,正是大规模AI训练必须依赖B300这类专业服务器的根本原因。一、算力“剪刀差”:大规模训练的第一道硬门槛过去几年,AI大模型的发展呈现出一个显著规律:模型参数量每18个月增长约10倍,而单卡算力同期仅提升约2倍。这个巨大的“剪刀差”意味着:仅靠硬件自然迭代,企业永
2026-7-23 查看更多 >> -
大模型时代,B300服务器何以成为算力“压舱石”?
如果说算法是大模型的“大脑”,数据是“血液”,那么算力就是支撑整个机体运转的“心脏”。当模型规模以每年10倍的速度膨胀,这颗心脏必须足够强劲——B300服务器,正是为此而生。一、算力“大考”:大模型时代的三重压力大模型不是简单地把模型“做大”,而是带来了一套全新的算力范式。以下三重压力,让传统服务器纷纷“亮红灯”:压力①:参数爆炸——显存与算力的双重挤压模型代际参数量FP16显存需求典型训练时间(
2026-7-23 查看更多 >> -

纵横算力工厂正式上线,开启企业智能计算新时代!
随着人工智能、大模型应用进入规模化发展阶段,企业对高性能算力、灵活部署能力以及稳定可靠的 AI 基础设施需求持续增长。纵横数据依托多年 IDC、云计算及 AI 算力资源运营经验,正式推出「纵横算力工厂」——面向企业客户打造的一站式大模型工厂与智算服务平台。平台聚合多元化 AI 算力资源,提供模型调用、API 服务、智能计算、应用开发等全链路能力,帮助企业快速连接大模型技术,降低 AI 应用落地
2026-7-9 查看更多 >> -
AI算力不足?B200服务器如何成为企业破局的关键?
人工智能正在从“锦上添花”变成企业竞争的“必修课”。从训练行业大模型,到部署智能客服、知识库和实时推理应用,AI的落地场景越来越丰富。但许多企业在推进过程中,真正卡住进度的往往不是算法或数据,而是一个更基础的问题——算力不够。模型训练慢、任务排队、推理延迟高、多个项目抢不到资源……这些问题正在实实在在地拖慢企业的创新节奏。尤其在大模型时代,传统服务器在计算能力、显存容量和数据吞吐上纷纷触及天花板,
2026-7-23 查看更多 >> -
大模型训练成本高,B200服务器如何提升效率?
训练一个大模型有多贵?圈内常有人开玩笑:“大模型不是炼出来的,是烧钱烧出来的。”从海量数据清洗、千亿参数迭代,到无数次调优验证,每一步都在消耗天量算力。对于大多数企业而言,算法人才可以招,数据可以攒,但每月的GPU账单和漫长的训练周期,才是真正让人头疼的硬门槛。面对动辄数百万甚至上千万的训练成本,企业需要的不仅是“更强”的硬件,更是一套能把每一分算力都转化为有效进度的效率方案。搭载NVIDIA
2026-7-23 查看更多 >> -
B200服务器在AI算力集群中,到底扮演什么角色?
过去,企业跑AI模型,一台高端GPU服务器基本够用。但现在,大语言模型、多模态视觉模型、行业大模型动辄千亿、万亿参数,数据量也从GB级跃升到TB甚至PB级。单机作战的时代已经过去,AI算力集群成为企业必备的基础设施。但集群不是简单地把几十上百台服务器用网线连起来。一个高效的AI集群,需要计算节点强劲、数据流转顺畅、任务调度灵活,还要能弹性扩展。在这个复杂的系统里,搭载NVIDIA B200 G
2026-7-23 查看更多 >> -
B200服务器如何帮助企业降低AI计算瓶颈?
不少企业AI项目推进到一半,常常会卡在一个尴尬的节点——算法验证通过了,数据也准备好了,但服务器跑不动了。训练一个模型要等几周,推理服务在高峰期频频超时,多个团队抢算力抢到“打架”……这些问题背后,指向同一个根源:AI算力瓶颈。它不再是技术团队的内部烦恼,而是直接影响业务上线速度、客户体验和研发成本的战略级障碍。搭载NVIDIA B200 GPU的新一代服务器,正是针对这些“堵点”设计的。它不
2026-7-23 查看更多 >> -
从GPT类模型训练,看B200服务器的算力优势到底在哪?
GPT系列大语言模型的崛起,把AI的能力边界推到了一个新高度。从智能问答、内容创作,到企业知识库、行业分析、代码生成,大模型正在从一个技术概念变成企业业务升级的真实引擎。但硬币的另一面是:模型越大,算力越“吃”得凶。千亿甚至万亿参数,TB级的训练数据,数周甚至数月的连续计算——这对任何企业的算力基础设施都是一场严峻大考。有人说,训练GPT类模型就像“烧钱”,但更准确的说法应该是“烧算力”。而搭载N
2026-7-23 查看更多 >>
- 首页
- 算力工厂
-
产品中心
- 腾讯云服务器
- 广州云服务器
- 上海云服务器
- 南京云服务器
- 成都云服务器
- 重庆云服务器
- 韩国云服务器
- 日本云服务器
- 新加坡云服务器
- 泰国云服务器
- 印尼云服务器
- 德国云服务器
- 弗吉尼亚云服务器
- 硅谷云服务器
- 巴西云服务器
- 沙特云服务器
- 动态拨号VPS
- 全国混拨
- 香港拨号
- 台湾拨号
- 新加披拨号
- 美国拨号
- 日本拨号
- 辽宁拨号
- 江苏拨号
- 浙江拨号
- 福建拨号
- 江西拨号
- 山东拨号
- 河北拨号
- 河南拨号
- 湖北拨号
- 安徽拨号
- 广东拨号
- 广西拨号
- 重庆拨号
- 四川拨号
- 陕西拨号
- 虚拟主机空间
- 德国空间
- 最新活动
- 解决方案
- 帮助中心
- 新闻资讯
- 关于我们



 闽公网安备35020302000189